GEO
Google AI Mode vernieuwd voor zoekvragen met veel eisen
Op je locatiepagina kunnen capaciteit en toegankelijkheid allebei kloppen, terwijl ze over verschillende zalen gaan. Google AI Mode krijgt met Gemini…
GEO
Een AI-assistent die op jouw website een cursus zoekt, kan de pagina openen en toch vastlopen bij het datumfilter. Google publiceerde op 17 november 2026 een handleiding om Google-Agent toegang te geven. Daarbij kun je het gebruik van filters door een assistent los beoordelen van het crawlen van filterpagina’s voor SEO.
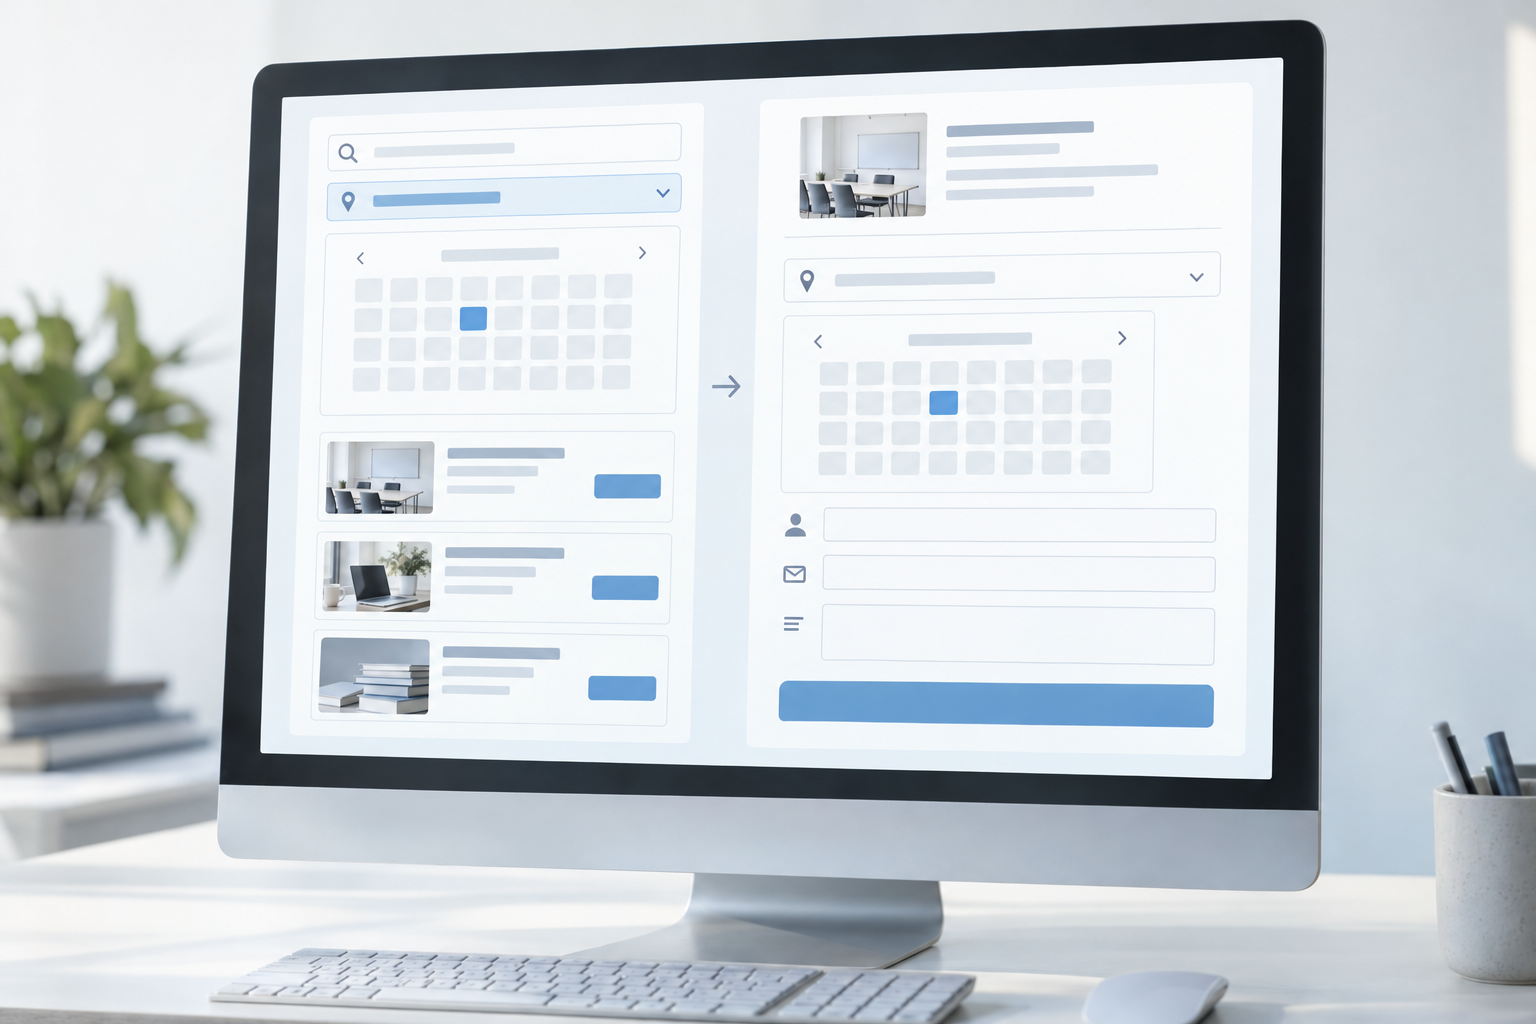
Google-Agent is de herkenningsnaam voor agents op Googles infrastructuur die op verzoek van gebruikers websites bezoeken en handelingen uitvoeren. De nieuwe handleiding kijkt nadrukkelijk verder dan de homepage: ook interne zoekfuncties, filters, detailpagina’s, winkelmandjes en boekingen komen aan bod. Inclusief de achterliggende API-verzoeken waarmee je website gegevens uitwisselt.
Een CAPTCHA-controle bij het zoeken of verzenden van een formulier kan zo’n vervolgstap alsnog blokkeren, schrijft Google. De uitleg is bedoeld voor website-eigenaren die dit verkeer willen toelaten. Het is geen aankondiging van een Nederlandse productuitrol; welke Google-diensten hier precies beschikbaar zijn, blijkt niet uit deze handleiding.
Voor je website ontstaat een interessante combinatie. Je wilt misschien dat een assistent een locatie en datum kan kiezen, terwijl je niet wilt dat Googlebot iedere mogelijke filtercombinatie crawlt. Googlebot is de crawler voor Google Search. Google-Agent voert handelingen uit op verzoek van een gebruiker. Die rollen vragen om een verschillende afweging.
In zijn documentatie over filter-URL’s adviseert Google het crawlen te beperken wanneer die pagina’s niet in zoekresultaten nodig zijn. Google geeft daarvoor onder meer robots.txt-regels voor Googlebot. Tegelijk schrijft Google dat user-triggered fetchers, de categorie waarin Google-Agent staat, doorgaans robots.txt-regels negeren omdat een gebruiker het verzoek heeft gestart.
Daaruit volgt niet dat iedere agent altijd ieder filter kan bedienen. Wel kunnen we de twee keuzes uit elkaar trekken: welke filterpagina’s wil je laten crawlen, en welke handelingen wil je voor een geverifieerde assistent bereikbaar maken?
Neem als denkvoorbeeld een cursuswebsite. Een combinatie van locatie en beschikbare datum kan nuttig zijn om een cursus te kiezen, zonder dat je die combinatie als zelfstandige zoeklandingspagina nodig hebt. Je kunt het Googlebot-beleid daarvoor behouden en afzonderlijk beoordelen of Google-Agent het filter en de achterliggende gegevensverzoeken mag gebruiken.
We zouden bestaande crawlbeperkingen dus niet verwijderen alleen omdat je AI-assistenten wilt toelaten. Of een filtercombinatie een eigen landingspagina verdient, blijft een aparte SEO-afweging tussen filters met parameters en statische filterpagina’s.
Daarbij blijft één grens belangrijk: robots.txt beveiligt geen privégegevens en garandeert niet dat een URL uit zoekresultaten blijft. Voor afgeschermde informatie heb je echte toegangsbeveiliging nodig.
Google adviseert om zowel de user-agent, de identificatietekst in het verzoek, als het herkomst-IP te controleren. Dat IP moet overeenkomen met de gepubliceerde reeksen in user-triggered-agents.json. Alleen de tekst Google-Agent herkennen is onvoldoende: die naam kan worden nagebootst.
Voor geverifieerde verzoeken adviseert Google bot challenges, zoals CAPTCHA-controles, over te slaan. Daarnaast experimenteert het bedrijf met Web Bot Auth, waarmee agents verzoeken digitaal ondertekenen. Niet ieder verzoek heeft zo’n handtekening. De bestaande verificatiemethoden blijven daarom nodig.
Onze veiligheidsafweging: beperk de uitzondering tot de bedoelde botcontroles. Dat een verzoek van een echte Google-agent komt, bewijst op zichzelf niet dat een bepaalde klant toegang tot een account heeft of een bestelling heeft goedgekeurd. Accountrechten en vereiste goedkeuringen horen dus niet automatisch mee te verdwijnen.
Een agent zonder geldige klantrechten weigeren kan precies de juiste uitkomst zijn. Niet iedere weigering is een technisch probleem dat je moet wegpoetsen.
Ook na het toelaten van de agent blijft de inhoudelijke uitkomst tellen. In het cursusvoorbeeld willen we weten of de gekozen datum behouden blijft tot in het aanvraagformulier, niet alleen of de filterknop reageert.
De formulierdocumentatie van web.dev benadrukt dat gegevens ook op de backend, de server die de aanvraag verwerkt, moeten worden gevalideerd. Een klik op verzenden zouden we daarom niet als bewijs van een geslaagde aanvraag gebruiken. De relevante uitkomst is dat het ontvangende systeem de aanvraag volgens de normale regels heeft geaccepteerd.
Een bruikbare test is om met fictieve gegevens eerst ongeldige en daarna geldige invoer aan te bieden. Kan de fout worden hersteld? Komt vervolgens de juiste cursusdatum binnen? Een onvolledig formulier terecht afwijzen is geen reden om validatie uit te schakelen.
Voor een Nederlandse webshop wordt het verschil tussen een uitgevoerde taak en een afgeronde aankoop extra concreet bij betalen. Betaalvereniging Nederland beschrijft dat de consument bij iDEAL naar de eigen bankomgeving gaat om de betaling te controleren en te bevestigen.
Stel dat een agent een winkelmandje correct voorbereidt en de klant daarna laat overnemen. Als productkeuze en bestelgegevens behouden blijven, kan dat een nuttige agentbijdrage zijn. We zouden die overdracht niet automatisch als technische uitval tellen, maar evenmin als bevestigde betaling.
Houd dus drie uitkomsten uit elkaar: winkelmand voorbereid, klant overgedragen en betaling bevestigd. De bevestiging in de bankomgeving hoort niet op één hoop met een botcontrole op je website. Dit is een mogelijk procesontwerp, geen bevestiging dat Google-Agent jouw iDEAL-koppeling ondersteunt.
Alleen in Google Analytics kijken geeft onvoldoende houvast voor een toegangstest. Google sluit bekend botverkeer automatisch uit, zonder zichtbaar te maken hoeveel verkeer is uitgesloten. Of Google-Agent daar momenteel onder valt, vermeldt de hulppagina niet. Uit een ontbrekend bezoek kun je dus niet afleiden waar een opdracht vastliep.
Ook een IP-adres is geen klantnummer. Google meldt dat gelijktijdige verzoeken van verschillende gebruikers dezelfde uitgaande IP-pool delen.
We zouden daarom de toegangsregistratie naast de bereikte taakstap en het resultaat in je aanvraag- of betaalsysteem leggen. Dit is een voorgesteld diagnosemodel, geen Google-rapportage:
| Waarneming | Wat je daarmee kunt vaststellen | Wat nog niet vaststaat |
|---|---|---|
| Geverifieerd verzoek is toegelaten | De betreffende toegangscontrole is gepasseerd | Of de opdracht uitvoerbaar is |
| Juiste filterkeuze staat in de vervolgstap | Die keuze is behouden | Of een aanvraag is geaccepteerd |
| Klant krijgt de voorbereide bestelling te zien | De overdracht is bereikt | Of de betaling is bevestigd |
| Aanvraag of betaling is bevestigd in het ontvangende systeem | Het bijbehorende bedrijfsresultaat is vastgelegd | Of alleen de agent daarvoor verantwoordelijk was |
Zonder een echte Google-Agent-sessie kun je de functionele route alvast testen. Noem dat dan een functionele test, geen bewezen Google-Agent-compatibiliteit. Een specifieke taak die werkt, met duidelijke beveiligingsgrenzen en een controleerbaar eindresultaat, zegt meer dan een algemeen vinkje ‘toegankelijk voor AI’.
Google Search Central
Allow Google-Agent traffic
Google Search Central
Google's crawling documentation changelog
Google Search Central
List of Google user-triggered fetchers
Google Search Central
Authenticate requests with Web Bot Auth (experimental)
Google Search Central
Googlebot
blogs.bing.com
Your choice: Turn AI answers on or off in Bing
Google Search Central
Latest Google Search documentation updates
GEO
Op je locatiepagina kunnen capaciteit en toegankelijkheid allebei kloppen, terwijl ze over verschillende zalen gaan. Google AI Mode krijgt met Gemini…
GEO
OpenAI heeft op 10 november Business Hub in bèta geïntroduceerd. Daarmee kunnen bedrijven hun profiel in ChatGPT claimen en inzicht krijgen in…
GEO
Je website kan de eerste uitleg leveren in Googles AI-zoekgesprek, terwijl bij de vervolgvraag een concurrent adverteert. Google kondigde op 28…