SEO
MarketingCollega officieel onderdeel van Semrush Agencies Platform
MarketingCollega is officieel opgenomen in het Semrush Agencies Platform. Een mooie stap die iets zegt over hoe hier dagelijks met SEO wordt gewerkt.
SEO
Laten bezoekers op je website een berekening of resultaat bewaren en delen via een link, of downloaden als PDF? Google adviseert per pagina te kiezen: is die bedoeld voor zoekresultaten, of alleen voor wie de link krijgt? Vergeet daarbij het PDF-bestand niet, en houd de openbare tool zelf wel vindbaar.
Bijgewerkt
Redactie MarketingCollega
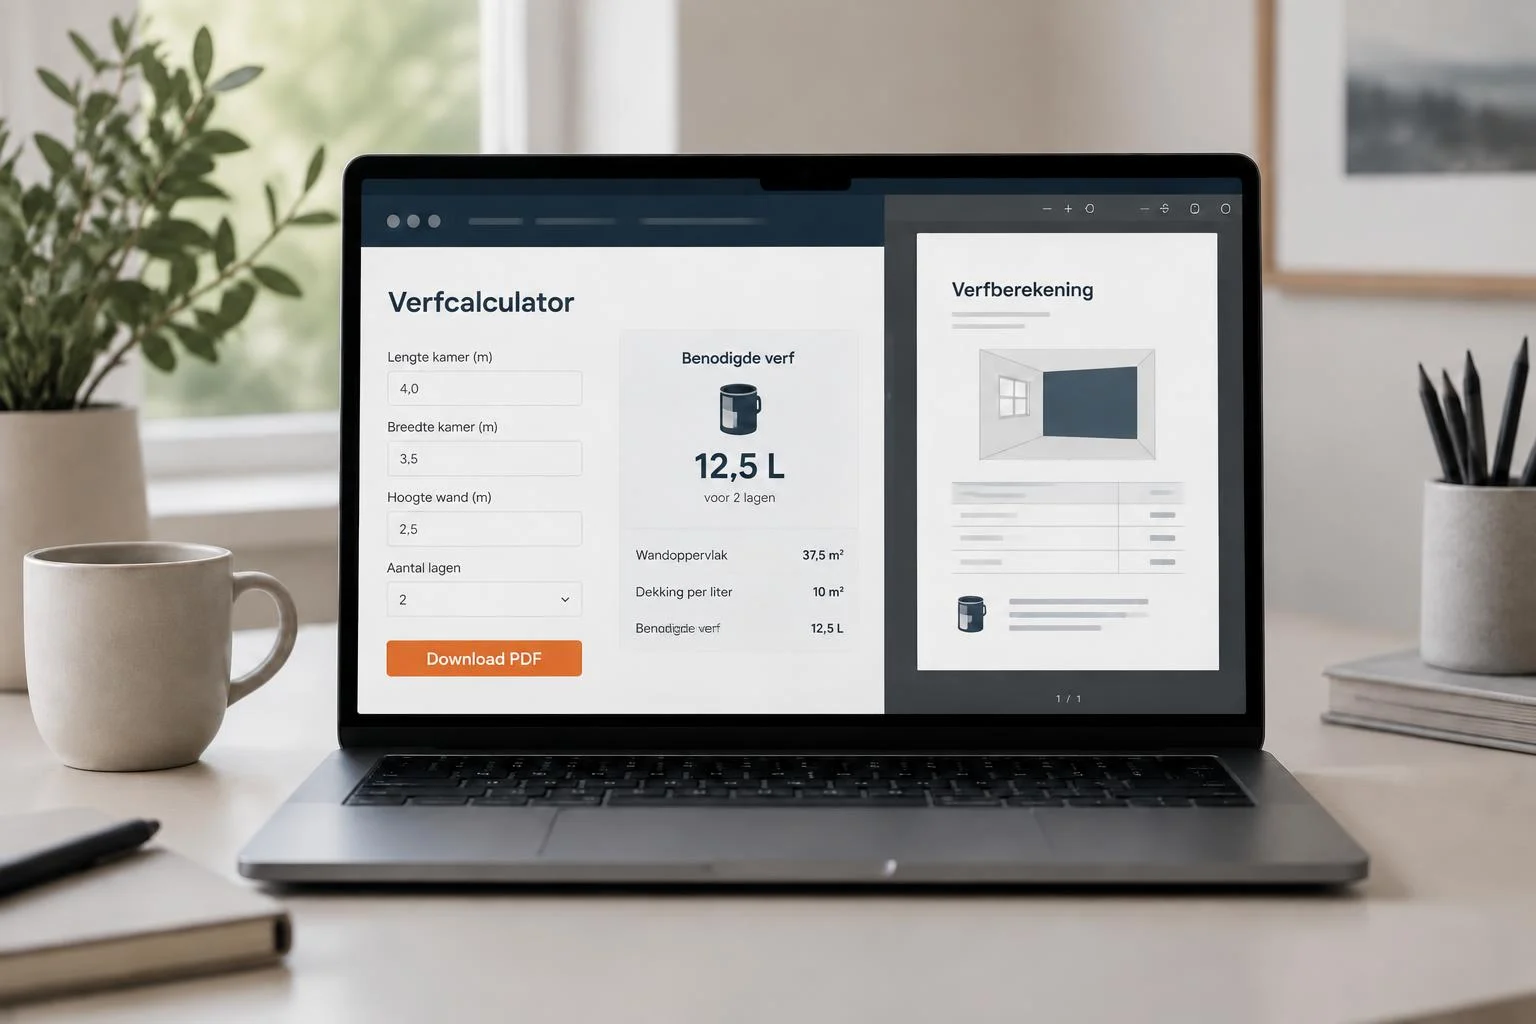
Stel: je hebt een Nederlandse kluswebsite met een verfcalculator. Bezoekers berekenen hoeveel verf ze nodig hebben, bewaren hun uitkomst en downloaden een lijstje als PDF. De calculator moet nieuwe bezoekers aantrekken. Maar moet iedere opgeslagen berekening ook een zoekresultaat worden? En wat gebeurt er met het downloadbestand?
We gebruiken dit voorbeeld om Googles advies praktisch uit te werken. De belangrijkste keuze zit al vóór de technische instelling: rechtstreeks delen en publiceren voor zoekmachines verdienen elk een eigen beslissing.
Bij vertrouwelijke inhoud ligt de grens eerder. Google adviseert daarvoor wachtwoordbeveiliging, zodat alleen bevoegde gebruikers toegang hebben. Noindex, de instructie om content niet in zoekresultaten op te nemen, laat rechtstreeks bezoek via een link gewoon toe. Gebruik het dus niet als toegangsbeveiliging.
In zijn handleiding tegen gebruikersspam noemt Google expliciet deelbare pagina's, gegenereerde resultaten en interactieve tools. Website-eigenaren moeten afwegen of die content bedoeld is voor zoekmachines of alleen voor mensen met een link.
Google schrijft daarmee niet alle gebruikerscontent af. Dezelfde handleiding beschrijft bijvoorbeeld dat je bijdragen van nieuwe gebruikers eerst kunt uitsluiten en later indexatie kunt toestaan wanneer hun reputatie groeit.
Voor onze voorbeeldwebsite zouden we de openbare calculator en zorgvuldig uitgewerkte voorbeeldberekeningen beschikbaar houden voor Search. Een losse, niet-vertrouwelijke berekening die iemand alleen wil doorsturen, zouden we standaard buiten Google houden. Dat is een voorgestelde inrichting, geen constatering over bestaande Nederlandse websites.
Hier wordt een instelling op één pagina al snel te klein voor het probleem. Volgens Googles technische documentatie werkt een robots meta tag, een instructie in de HTML, op een afzonderlijke pagina. Voor een PDF kan de server X-Robots-Tag: noindex meesturen in de HTTP-header: informatie die bij het bestand wordt geleverd.
Daaruit volgt een belangrijk controlepunt: een uitgesloten HTML-resultaatpagina bewijst niet dat het bijbehorende PDF-rapport ook is uitgesloten. Het zijn afzonderlijke URL's met afzonderlijke antwoorden van de server.
We zouden de publicatiekeuze daarom laten doorwerken naar alle uitvoervormen van hetzelfde resultaat:
Pas dit gericht toe op de resultaatbestanden. Een algemene regel die alle PDF's uitsluit, zou ook bewust openbare handleidingen raken. Dat is een flinke omweg als je alleen opgeslagen berekeningen uit Google wilde houden.
Googles handleiding tegen gebruikersspam noemt zowel noindex als het blokkeren van crawling via robots.txt. De specifieke noindex-documentatie maakt duidelijk waarom die middelen niet uitwisselbaar zijn.
Google moet een pagina of bestand kunnen ophalen om de noindex-instructie te lezen. Blokkeer je diezelfde URL in robots.txt, dan kan Google de instructie niet verwerken. Volgens Google kan de URL vervolgens toch in zoekresultaten verschijnen, bijvoorbeeld doordat andere pagina's ernaar linken.
Voor een niet-vertrouwelijk resultaat dat bereikbaar mag blijven via een link, maar niet in Google hoort, zouden we daarom noindex gebruiken en Googlebot toegang geven om die instructie te lezen. Maak vertrouwelijke bestanden hiervoor nooit openbaar. Daar blijft toegangsbeveiliging de eerste stap.
Een knop om een resultaat te delen hoeft niet tegelijk toestemming voor zoekvindbaarheid te betekenen. In ons ontwerp krijgt de verfcalculator daarom twee aparte handelingen: een resultaat delen en een berekening als openbaar voorbeeld publiceren.
Bij die tweede handeling zouden we controleren of de berekening ook zonder de oorspronkelijke gebruiker begrijpelijk en nuttig is. Welke aannames zijn gebruikt? Voor welk oppervlak geldt het voorbeeld? Welke uitleg heeft een nieuwe bezoeker nodig? Dit is onze inhoudelijke publicatiekeuze, niet een aanvullende eis van Google.
Laat vervolgens ook de sitemap aansluiten op die keuze. Google adviseert daarin de URL's op te nemen die je in zoekresultaten wilt zien. Wij zouden dus de calculator en goedgekeurde voorbeelden opnemen, niet automatisch iedere opgeslagen uitkomst. Gebruik die selectie naast de juiste indexatie-instellingen, niet als vervanging daarvan.
De overgang van gedeeld resultaat naar openbaar voorbeeld verdient een eigen test. Google beschrijft dat een robots meta tag of header die indexatie verbiedt, kan verhinderen dat een pagina in de wachtrij voor rendering komt. Tijdens rendering verwerkt Google de pagina en voert het JavaScript uit.
Daarom zouden we niet vertrouwen op een script dat een aanvankelijke noindex pas in de browser verwijdert. Laat de eerste HTML die je server terugstuurt al passen bij de gewenste publicatiestatus.
Controleer daarnaast de HTTP-headers. Volgens Google geldt bij conflicterende robotsregels de meest beperkende regel. Heb je de noindex uit de HTML verwijderd, maar stuurt de server nog een noindex-header mee? Dan kan die achtergebleven instructie de beoogde vrijgave blijven tegenhouden.
Een andere mogelijke oplossing klinkt aantrekkelijk: geef alle resultaten een canonical naar de calculator. Een canonical is een aanwijzing voor de voorkeursversie van dubbele of sterk vergelijkbare pagina's.
Maar Google garandeert niet dat het die voorkeur volgt. Bovendien is een berekening met ingevulde oppervlaktes niet automatisch een duplicaat van de algemene uitleg over de tool.
Onze afweging: gebruik een canonical wanneer je bij vergelijkbare openbare versies een voorkeur wilt aangeven. Wil je dat een resultaat helemaal niet in Google verschijnt, kies dan een daarvoor bedoelde uitsluitingsmaatregel. Een voorkeur aanwijzen biedt daarvoor onvoldoende zekerheid.
Een instelling aanpassen is één stap. Vaststellen dat Google die heeft verwerkt, is een volgende. Google moet de gewijzigde pagina immers opnieuw ophalen om een toegevoegde noindex te zien.
We zouden de controle zo opbouwen:
Google adviseert ook te letten op onverwachte groei in geïndexeerde pagina's, vertoningen en zoekopdrachten die niet bij je platform passen. Bekijk zo'n stijging eerst per paginatype. Groeit de openbare calculator, of groeit vooral de verzameling opgeslagen resultaten?
Andersom is een toename van uitgesloten pagina's niet automatisch een SEO-probleem. Google benadrukt dat niet iedere URL geïndexeerd hoeft te zijn. Bij bewust uitgesloten deelresultaten kan dat juist de gewenste uitkomst zijn.
Inventariseer eerst welke URL's bij het resultaat horen, inclusief eventuele exports. Herstel daarna de structurele instellingen. Bij vertrouwelijke inhoud betekent dat eerst de toegang beperken.
Moet een zoekvermelding dringend weg, dan kan de verwijdertool van Search Console voor een eigen property als overbrugging dienen. Google beschrijft dit als een tijdelijke verwijdering van ongeveer zes maanden; voor blijvende verwijdering zijn aanvullende maatregelen nodig.
De nuttigste opdracht aan je ontwikkelaar is dus concreter dan ‘zet de resultaten op noindex’. Leg vast wat er bij delen, downloaden en openbaar publiceren moet gebeuren, en controleer die handelingen afzonderlijk. Dan blijft de openbare tool beschikbaar voor Search, zonder dat iedere bewaarde uitkomst automatisch dezelfde behandeling krijgt.
Google Search Central
Prevent user-generated spam on your site and platform
Google Search Central
Block Search indexing with noindex
Google Search Central
Control what you share with Google Search
Google Search Central
Search Central Live in Zurich is back!
SEO
MarketingCollega is officieel opgenomen in het Semrush Agencies Platform. Een mooie stap die iets zegt over hoe hier dagelijks met SEO wordt gewerkt.

SEO
Veel SEO-specialisten en website-eigenaren zagen begin september iets opvallends in hun Google Search Console: grafieken die jarenlang stabiel waren…