SEO
Google: een CDN kan je website versnellen én je server belasten
Je website sneller maken met een Content Delivery Network (CDN), dat kopieën van websitebestanden levert, kan de server bij je hostingprovider juist…
SEO
Meer Google-klikken naar je website kunnen vooral komen van mensen die jouw merk zoeken. Google maakt zijn merkfilter sinds 16 november 2026 beschikbaar via de Search Analytics API, de koppeling voor automatische zoekrapportages. Alleen websites die aan de voorwaarden voldoen krijgen die gegevens. En groei buiten je eigen merk is nog niet automatisch groei op algemene zoekvragen.
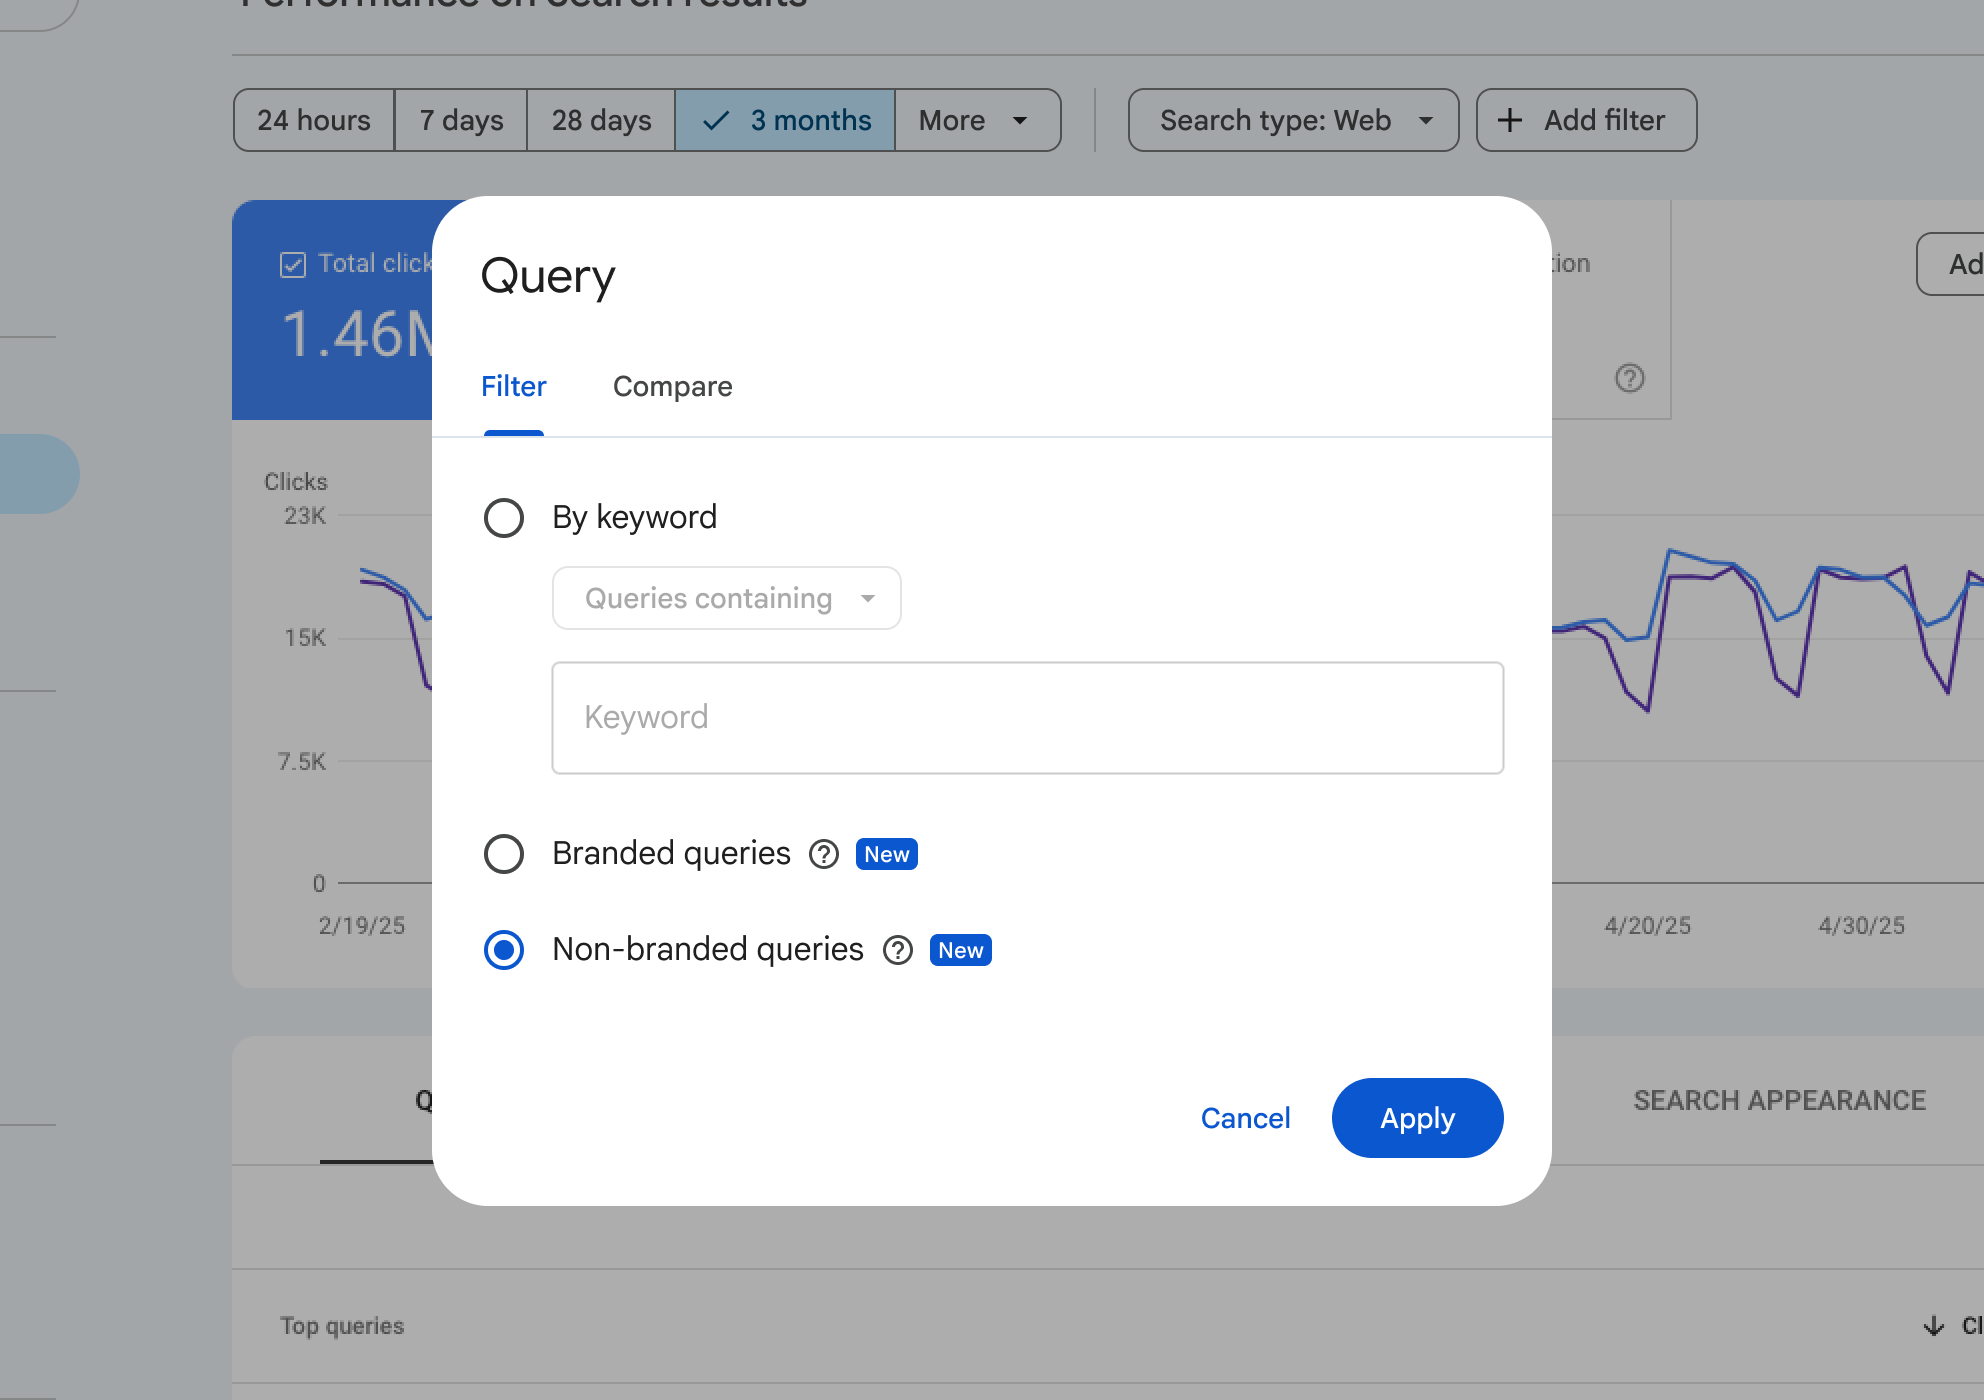
De uitbreiding brengt drie bestaande Search Console-functies naar automatische rapportages. Naast de merksplitsing voegt Google rapportage over zoeken met beelden toe, plus filters waarmee je meerdere landen of apparaten in één verzoek selecteert. Het merkfilter zelf bestond dus al. Nieuw is dat je Googles indeling rechtstreeks kunt gebruiken in eigen dashboards en geautomatiseerde analyses.
Dat is handig als je nu zelf een lijst met merkwoorden bijhoudt. Maar vervang die lijst niet ongemerkt door Googles indeling. Je grafiek kan daardoor veranderen zonder dat er één klik bij komt. We zouden zo'n overstap behandelen als een wijziging van de meetmethode.
Google kijkt verder dan de letterlijke bedrijfsnaam. Volgens de oorspronkelijke uitleg herkent het AI-ondersteunde systeem ook taalvarianten, spelfouten en zoekopdrachten naar unieke producten of diensten van de website. Een zoekopdracht kan dus als merkgebonden tellen zonder dat jouw bedrijfsnaam erin staat.
Dat kan nuttiger zijn dan een beperkte eigen woordenlijst. Tegelijk waarschuwt Google dat zoekopdrachten verkeerd kunnen worden ingedeeld. Een verschil tussen beide methoden is daarom niet meteen een Google-fout: misschien mist je eigen lijst juist een productnaam of schrijfvariant.
De beschikbaarheid heeft grenzen. Google vereist voldoende zoekopdrachten en vertoningen en een Search Console-property op het hoogste niveau. Properties voor een afzonderlijke map of subdomein vallen erbuiten. Voor een website die niet in aanmerking komt, geeft de API bij deze merksplitsing geen rijen terug. Zo'n leeg antwoord mag je dashboard dus niet als nul merkklikken presenteren.
Googles tweedeling gaat over jouw merk en de nauw daarmee verbonden producten. Voor de vraag waarop je website breder wordt gevonden, kan die indeling te grof zijn.
Neem een denkbeeldige Nederlandse webshop die hardloopschoenen van verschillende fabrikanten verkoopt. Een zoekopdracht met je winkelnaam, een zoekopdracht naar een extern schoenenmerk en een vraag als ‘hardloopschoenen voor beginners’ vertellen niet hetzelfde verhaal.
Als Google die fabrikantzoekopdracht onder NON_BRANDED schaart, kan groei in dat segment betekenen dat je meer klikken krijgt rond die fabrikant. Dat bewijst nog geen groei op algemene productvragen. Het is wel degelijk relevante groei, alleen een andere soort dan je misschien op basis van het label verwacht.
Voor zo'n webshop zouden we naast Googles indeling daarom een eigen onderscheid behouden: het eigen winkelmerk en eigen productlijnen, externe fabrikantmerken, algemene productvragen en twijfelgevallen. Daarmee kun je gerichter uitleggen waar extra verkeer vandaan komt. Welke concrete zoekopdracht Google welk label geeft, moet uit de gegevens blijken; het voorbeeld voorspelt dat niet.
Een eerlijke vergelijking begint met dezelfde selectie: dezelfde website, periode, apparaten en hetzelfde zoektype. Rapporteer je over de Nederlandse markt, gebruik dan in beide reeksen dezelfde landselectie.
Daar zit een klein maar belangrijk verschil in betekenis. Google definieert het land als de plek waar de zoekopdracht vandaan kwam. ‘Zoekverkeer uit Nederland’ is dus een preciezer dashboardlabel dan ‘Nederlandstalig zoekverkeer’. Je selecteert hiermee geen taal.
Voor de inhoudelijke controle zouden we de beschikbare zoekopdrachten per Google-groep ophalen en daarna je eigen merkregels toepassen op precies diezelfde rijen. Doe die tweede indeling buiten de API. De referentie staat namelijk niet toe dat je brandedClassification, de technische naam van de merkindeling, combineert met een zoekopdrachtfilter in hetzelfde verzoek.
Bekijk vervolgens vooral de verschillen: welke zoekopdrachten noemt alleen Google merkgebonden, en welke alleen jouw eigen methode? Begin bij afwijkingen met veel klikken. Daar kan een andere definitie het zwaarst doorwerken in je rapportage.
Het aandeel klikken op rijen waar de indelingen verschillen, is een bruikbaar verschilpercentage. Noem het geen foutpercentage. Je eigen woordenlijst is tenslotte ook geen scheidsrechter die altijd gelijk heeft.
Zelfs als beide methoden het meestal eens zijn, weet je nog niet of je genoeg van het verkeer hebt kunnen beoordelen.
Google documenteert dat geanonimiseerde zoekopdrachten niet als afzonderlijke zoekopdrachtrijen verschijnen, terwijl ze wel in ongefilterde totalen kunnen meetellen. Bovendien kan detaillering naar zoekopdracht of pagina gegevens laten wegvallen. De API-handleiding noemt daarnaast maximaal 50.000 rijen per dag per zoektype.
Daarom zouden we naast het verschilpercentage ook de zoekwoorddekking tonen: welk aandeel van alle klikken zit in de rijen die je daadwerkelijk hebt vergeleken? Vraag daarvoor het totaal apart op, zonder zoekopdracht- of paginadimensie. Houd de overige selectie en de telling op websiteniveau gelijk. Deel daarna de klikken uit de gecontroleerde rijen door dat totaal.
Zo voorkom je dat een keurige overeenkomst tussen twee indelingen meer zekerheid uitstraalt dan de gegevens toelaten. Veel overeenstemming binnen het zichtbare deel zegt niets over de zoekopdrachten die ontbreken.
Ook de rekensom ‘alle klikken min mijn gevonden merkklikken’ verdient aandacht. Wat overblijft is niet automatisch gemeten niet-merkverkeer: daar kan ook verkeer tussen zitten waarvan je de zoekopdracht niet kunt beoordelen. Hoe de nieuwe merksplitsing precies met geanonimiseerde zoekopdrachten omgaat, blijkt niet uit de aankondiging. Vul dat ontbrekende antwoord niet zelf in met een handige dashboardformule.
De API-referentie noemt 21 februari 2026 als begin van de beschikbare classificatiedata. Een jaarvergelijking met november 2025 kun je dus niet uitsluitend met deze API-reeks maken.
Dat maakt een oude reeks op basis van je eigen merkwoordenlijst niet waardeloos. Integendeel: die kan juist helpen om historisch consequent te blijven meten. Maar plak die oude cijfers niet naadloos aan Googles nieuwe reeks alsof de definitie gelijk is gebleven.
Laat beide indelingen waar mogelijk naast elkaar lopen. Wil je historische perioden vergelijken met eigen regels, pas dan dezelfde regels toe op beide perioden, voor zover je daarvoor de benodigde gegevens hebt. Ontbrekende historie blijft ontbrekend, niet nul.
Groeit alleen Googles niet-merkgroep, terwijl je eigen groep algemene zoekvragen gelijk blijft? Dan is de volgende vraag welke fabrikantnamen, productnamen of twijfelgevallen het verschil verklaren.
Groeien beide groepen bij een vergelijkbare dekking, dan heb je een sterkere basis om meer verkeer buiten het eigen merk te rapporteren. Bekijk daarbij ook vertoningen, de doorklikratio (CTR) en posities voor vergelijkbare zoekopdrachten. Zelfs dan bewijst het merklabel niet dat jouw laatste SEO-aanpassing de oorzaak was.
De winst van deze update zit in het eenvoudiger automatisch rapporteren. De betekenis van die rapportage blijft een inhoudelijke keuze. Een extra lijn in je dashboard is snel geregeld; zorgen dat die lijn nog steeds dezelfde vraag beantwoordt, is het echte werk.
Google Search Central
New filtering and reporting capabilities in the Search Analytics API
Google Search Central
Search Analytics: query
Google Search Central
Introducing the branded queries filter in Search Console
blogs.bing.com
Your choice: Turn AI answers on or off in Bing
Google Search Central
Latest documentation updates
SEO
Je website sneller maken met een Content Delivery Network (CDN), dat kopieën van websitebestanden levert, kan de server bij je hostingprovider juist…
SEO
Je website kan in Search Console minder zichtbaar lijken in Googles AI-antwoorden door een meetfout. Google meldt te laag geregistreerde vertoningen…
SEO
Je bestaande webadressen aanpassen omdat Google koppeltekens (-) boven underscores (_) aanbeveelt? Google verduidelijkte dat URL-advies op 23 oktober…